LazyAgents loay hoay 3 tuần mà vẫn chưa ra đâu vào đâu
Vẫn chưa ổn lắm ae ạ, phát sinh nhiều vấn đề phết. Dọn dẹp xong vấn đề hạ tầng, điều phối memory thì nảy ra vấn đề verify bug. Tạm gọn ra vấn đề verify bug thì tòi ra vấn đề chi phí. Token optimize (In, Out, Cache) để làm sao đọc code như thế nào cho hiệu quả.
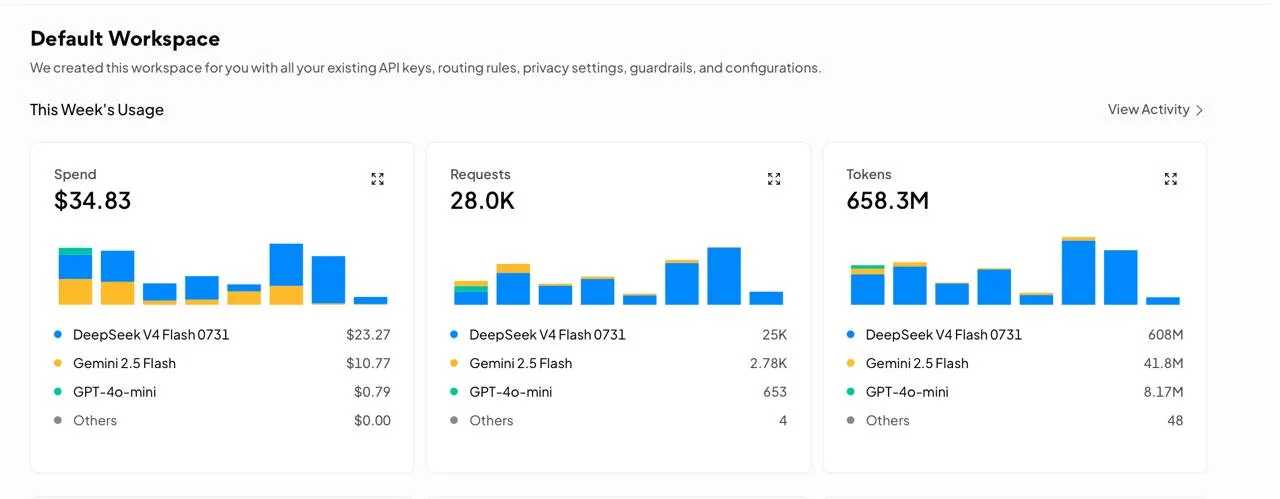
Chưa dám thử model khủng top tier, đang chỉ thử nghiệm với các model giá rẻ. Nếu để làm 1 cỗ máy xay bug chạy cả đêm lẫn ngày thì phần này mọi subsystem phải viết kỹ. Không thì nó như nước đổ ra ngoài mà không vào thùng. Phí lắm.
Vấn đề Context
Mỗi session thực hiện việc tiếp nhận các ứng cử viên (một lỗ hổng bị nghi ngờ) được phát hiện bởi các SAST Engine (LazySast, Joern, và CodeQL). Ba engine chạy độc lập, cho dù đã thực hiện việc deduplicate lỗ hổng mà 3 bọn này tìm ra theo Key(VulnClass:File:Line) thì vẫn còn hàng trăm lỗ hổng (Mình test với một dự án khoảng hơn 15k dòng ~ 3GB Code).
Theo taint-flow thì từ source tới sink không chỉ có 1 file, cả chuỗi ấy phải 3-10 files là chuyện bình thường. Mỗi Session lúc này phải nhồi source code vào để phân tích. Lúc này xuất hiện vấn đề Agent không nhớ chúng cần tìm cái gì ở đâu, nên cứ đọc đi đọc lại. Việc này khiến context bị thừa thãi (ca đang xử lý tới gần 50%)
Mà điên rồ ở chỗ, chỉ vì muốn tiết kiệm Token nên mình đã thực hiện việc nén context và hiện tại đang thiết lập giữ lại 6 trao đổi gần nhất. Còn data cũ hơn thì nén lại để lên đầu. Mà bạn biết rồi ấy, nén bản chất là việc làm mất một phần dữ liệu. Chúng chẳng biết chỗ nào mà tìm. Mà không tìm được chúng lại phải đọc lại. Mẹ kiếp! Một vòng luẩn quẩn!
Một số cách đang suy nghĩ có thể áp dụng:
-
Nới compaction thay vì giữ lại 6, thì giữ lại nhiều hơn
-
Ví lỗ hổng (Ledger Sink) chứa những candidate do các SAST Engine tìm ra cần lưu thêm snippet, thay vì chỉ có file:line
-
Các ứng cư viên được lấy (claim) từ ví ra để cho các agent hunter, validator xử lý thì trả về thêm snippet
-
Thay vì đọc cả file thì đọc theo vùng sink, vùng source.
Vấn đề Verify Bug
Verify bug cũng là 1 bài toán phức tạp: Tin Agent phân tích, hay tin exploit thật sự, nếu target không start lên được để exploit thì sử dụng cách nào để verify? Tự dựng code lên để tái tạo lại đoạn code bị lỗi như một dạng snippet ngắn và chạy thì có ổn không?
Mỗi ngôn ngữ lại có cách code và chạy snippet khác nhau, model nào đủ năng lực làm được điều đó :v. Đù mé, đau đầu thật sự. 3 tuần nay căng như dây đần, ngủ còn mơ luôn
Bài học từ lịch sử
Code các hệ thống sử dụng LLM như này thì theo kinh nghiệm của mình nên lưu lại hết các thông tin input, output, reasoning, token (in,out,cache), tên model, giá tiền của các model vào database. Việc này có ba mục đích:
-
Đo đạc được việc tối ưu lần trước và lần sau khác nhau như nào. Thực sự có tối ưu không. Vì nếu không lưu lại thì mình làm sao mà nhớ được
-
Dữ liệu của lịch sử giúp mình tìm nguyên nhân của các lỗi calling tool, loop, không trả về dữ liệu, hoặc việc gửi request lên LLM API bị treo
-
Tận dụng dữ liệu cũ để reproduce lại, replay lại các phiên làm việc cho nó đỡ phải chạy lại LLM (tốn tiền lắm)